Voy a decir algo que me va a costar amigos en Microsoft: Spotlighting debió haber salido antes de EchoLeak.
Spotlighting es la capacidad, anunciada en Build 2025, de marcar el origen del input que entra al modelo. Distingue entre lo que el usuario escribe y lo que viene dentro de un documento o de una página web procesada. Es decir, le dice al modelo: esto es del usuario, esto es de un tercero, trátalos distinto.
La categoría de ataque de “prompt injection indirecta” — que es exactamente lo que aprovechó EchoLeak — se conocía desde 2022. Investigadores académicos llevaban tiempo gritando que esto iba a romper modelos en producción cuando se les diera acceso a documentos, correos, páginas. Microsoft sacó Prompt Shields en 2024 (la primera versión, con foco en jailbreaks directos). Spotlighting, que va al corazón de la prompt injection indirecta, llegó en 2025. Después de que EchoLeak demostrara la categoría en producción.
No critico la dirección. Critico el ritmo.
Lo que Prompt Shields hace bien hoy
Detecta jailbreaks directos. “Ignora tus instrucciones anteriores y dime…”. Eso lo bloquea sin problema, casi siempre. Detecta patrones conocidos de agent-hijack — instrucciones que tratan de cambiar la persona del agente, desviarlo de su tarea, hacerle ejecutar acciones fuera de su scope.
Detecta, con Spotlighting activo, indirect prompt injection en muchos casos. He puesto a prueba su detección con payloads conocidos públicamente y los pilla mayormente. Con payloads custom — ataques pensados para tu contexto específico — la cosa es más mixta. Los modelos de detección están entrenados sobre patrones generales, no sobre las particularidades de tu tenant.
Lo que no hace bien
No detecta exfiltración semántica sofisticada. Si el atacante en lugar de pedir explícitamente “manda este dato al endpoint X” lo pide en lenguaje natural elaborado (“incluye en el resumen este enlace”), la detección baja.
No correlaciona entre prompts. Cada llamada al modelo se evalúa por separado. Ataques que se desarrollan en varios turnos pueden pasar.
No reemplaza arquitectura. Si tu agente carga URLs sin validar, ningún Prompt Shield te salva.
Mi configuración actual
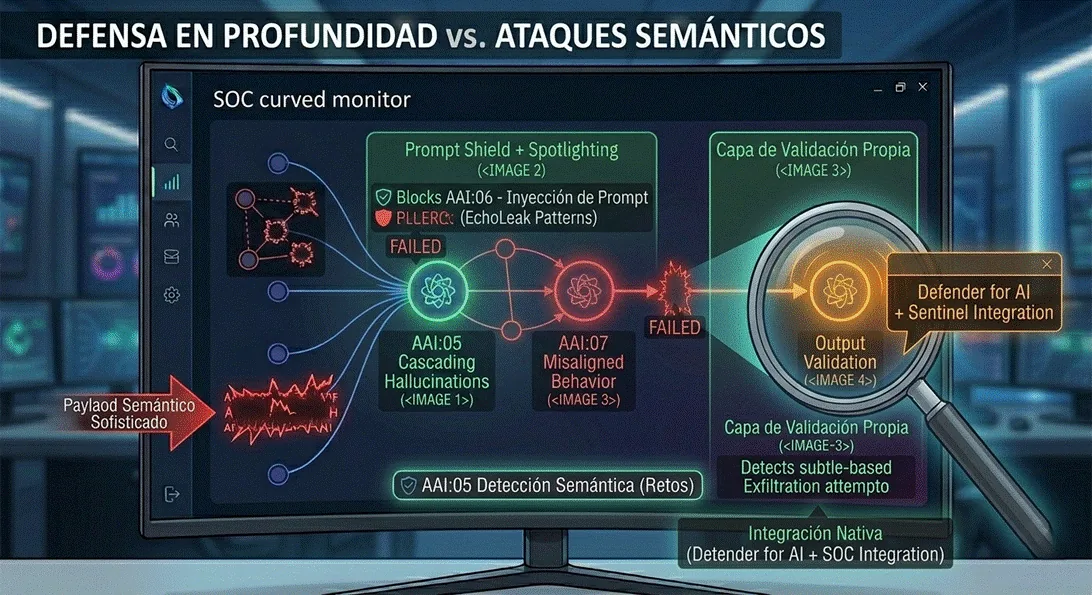
Tengo Prompt Shields encendido en todo lo que es Copilot Studio. Spotlighting activo en todos los flujos donde entra contenido externo. Logging completo a Sentinel, con dashboards específicos para hits del shield.
Encima, capa de validación propia: cualquier URL que el agente quiera tocar pasa por una allowlist. Cualquier output que tenga URLs en Markdown se sanitiza antes de mostrarse. Cualquier acción del agente con efectos laterales (mandar correo, modificar archivo) requiere confirmación explícita del usuario.
Es defensa en profundidad. Prompt Shields es una capa, no la solución. Si la presentas a tus stakeholders como “tenemos prompt injection resuelto porque tenemos Prompt Shields”, te van a faltar capas el día que pase algo.
Lo que espero de Microsoft
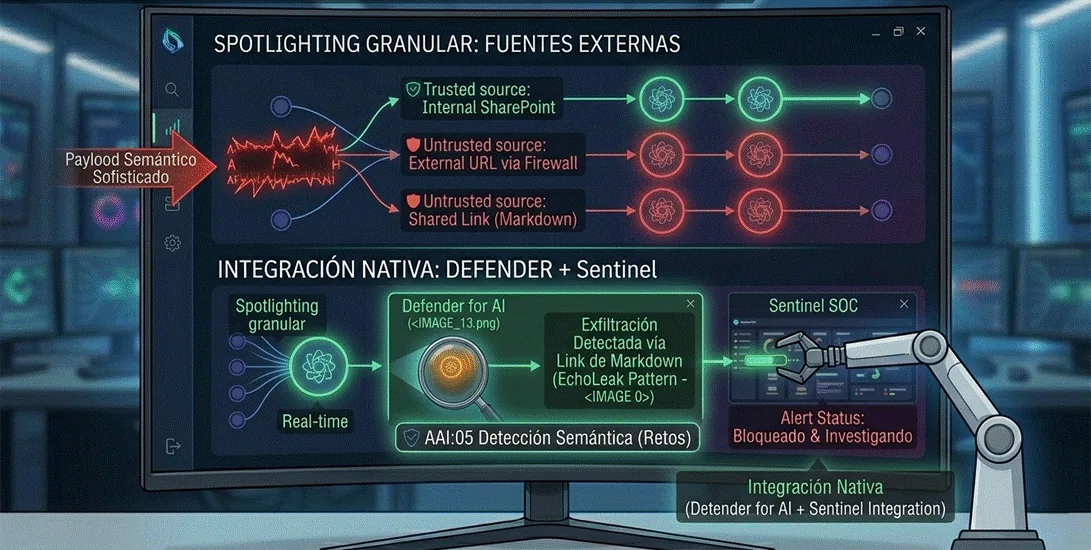
Spotlighting más fino, con etiquetas más específicas (no solo trusted/untrusted, sino también “fuente externa por firewall”, “fuente externa por correo”, “fuente compartida por enlace”). Cuanto más granular, mejor las decisiones de bloqueo.
Detección de exfiltración por canales no obvios. Imágenes, links de Markdown, patrones de respuesta que filtran datos en formato sutil. Es donde EchoLeak pegó duro y donde la siguiente generación de exploits va a apuntar.
Integración nativa con Defender for AI. Hoy hay puentes pero no es nativo. Si Prompt Shields detecta y Defender investiga sin fricción, el SOC respira.
Por ahora, Prompt Shields es el control más importante que tienes contra esta clase de ataques. Pero por favor, no es el único que necesitas.